比例代表選挙の今の配分方法はドント方式だが、最も民意に近い配分方法の最大剰余方式では得票率と改選議席数の積の整数部分に相当する議席の他に、残りの議席が小数部分の大きい順(1に近い「惜しい」順)に1議席ずつ配分される。その小数部分の値と議席を獲得できる確率の関係をグラフにして【比例代表選挙における政党合併後の議席の増減についての数学的考察】で示したのだが、シミュレーション結果を示しただけでグラフの形についての考察は省略した。今回は、そのグラフの形について深掘りする。

シミュレーションで生成した得票率の分布については、【比例代表選挙のシミュレーションで使った得票率の分布についての補足】で述べたとおりである。
得票率の順位が $i$ の政党の得票率を $p_{i}$、改選議席数を $C$ とすると、その積 $p_{i}C$ の値は整数部分 $\lfloor p_{i}C \rfloor$ と小数部分 $\{p_{i}C\}$ に分けられる。
\begin{align}
p_{i}C = \lfloor p_{i}C \rfloor + \{p_{i}C\} \label{eq:得票率と改選議席数の積}
\end{align}
まずは \eqref{eq:得票率と改選議席数の積} の整数部分 $\lfloor p_{i}C \rfloor$ の議席を各政党に配分し、残った議席数 $m$ を小数部分 $\{p_{i}C\}$ の大きい順に1議席ずつ配分するのが最大剰余方式である。
\begin{equation}
m=C - \sum_{i=1}^{n} \lfloor p_{i}C \rfloor=\sum_{i=1}^{n} \{p_{i}C\}\ \ \ (n は立候補政党数) \label{eq:小数の順位で配分される総議席数}
\end{equation}
小数部分 $\{p_{i}C\}$ は $p_{i}$ の値が大きくなるにつれて大きくなるが、$p_{i}C$ の値が自然数 $1,2,3,\dots$ に達するたびに $0$ に戻る。その周期は $\frac{1}{C}$ である。
そして、整数部分 $\lfloor p_{i}C \rfloor$ の値が同じであれば、得票率の順位の高い方が小数部分 $\{p_{i}C\}$ の値が大きい。
\begin{equation}
\lfloor p_{i}C \rfloor = \lfloor p_{i+1}C \rfloor \Rightarrow \{p_{i}C\} \gt \{p_{i+1}C\} \label{eq:同じ階級の小数部分の順位}
\end{equation}
また、整数部分 $\lfloor p_{i}C \rfloor$ の値が $0$ であれば、得票率と改選議席数の積 $p_{i}C$ がそのまま小数部分 $\{p_{i}C\}$ の値になる。
\begin{equation}
\lfloor p_{i}C \rfloor = 0 \Rightarrow \{p_{i}C\} = p_{i}C \label{eq:小政党の小数部分}
\end{equation}
したがって、整数部分 $\lfloor p_{i}C \rfloor$ で議席を獲得できなかった小政党の間で小数部分 $\{p_{i}C\}$ の順位で議席を獲得できるのは、得票率 $p_{i}$ の高い方ということになる。もちろん、複数の小政党が小数部分 $\{p_{i}C\}$ の順位で議席を獲得することもあるが、その場合でも得票率 $p_{i}$ の高い順である。
さて、まずは小数部分 $\{p_{i}C\}$ の順位で配分される議席数の総数 $m$ の値がどのくらいになるか見積もりたい。そのために、【比例代表選挙のシミュレーションで使った得票率の分布についての補足】で述べた「正規化後得票率の中央値の近似式」を使うことにする。
\begin{empheq}[left=\empheqlbrace]{alignat}{2}
&p_{\mathrm{med}}(k,n):=\frac{\operatorname{Med}(g(X))}{A}=\frac{1}{A \left( 1+e^{10(\frac{k - 1/3}{n + 1/3})} \right) }\\
&A=\sum_{k=1}^{n}\frac{1}{1+e^{10(\frac{k - 1/3}{n + 1/3})}}\label{eq:正規化定数}\\
&\operatorname{Med}(p_{i}) \approx p_{\mathrm{med}}(i,n)\label{eq:正規化後得票率の中央値の近似式}
\end{empheq}
$p_{i}C$ の中央値 $\operatorname{Med}(p_{i}C)$ は次の式で近似できる。
\begin{equation}
\operatorname{Med}(p_{i}C) \approx \frac{C}{A \left( 1+e^{10(\frac{i - 1/3}{n + 1/3})} \right) } \label{eq:得票率×改選議席数の中央値}
\end{equation}
この $\operatorname{Med}(p_{i}C)$ が閾値 $T_{h}$ を超える順位 $k$ を求める式を作る。
\begin{equation}
\operatorname{Med}(p_{k}C) \ge T_{h} \label{eq:得票率×改選議席数の中央値の閾値超え}
\end{equation}
$T_{h}$ が$1$ の場合は、整数部分 $\lfloor p_{i}C \rfloor$ で議席を獲得できる順位が見積もれる。また、$T_{h}$ を自然数 $1,2,3,\dots$ にすると、整数部分 $\lfloor p_{i}C \rfloor$ で議席数 $T_{h}$ を獲得できる順位も見積もれる。
では、\eqref{eq:得票率×改選議席数の中央値の閾値超え} の不等号を $k$ で解いていく。
\begin{align}
\frac{C}{A \left( 1+e^{10(\frac{k - 1/3}{n + 1/3})} \right) } &\ge T_{h} \notag\\
\left( 1+e^{10(\frac{k - 1/3}{n + 1/3})} \right) &\le \left( \frac{C}{T_{h} A} \right) \notag\\
e^{10(\frac{k - 1/3}{n + 1/3})} &\le \left( \frac{C}{T_{h} A} -1 \right) \notag\\
\frac{k - 1/3}{n + 1/3} &\le \frac{1}{10} ln \left( \frac{C}{T_{h} A} -1 \right) \notag\\
\end{align}
\begin{equation}
k \le \frac{n + 1/3}{10} ln \left( \frac{C}{T_{h} A} -1 \right) + \frac{1}{3} \label{eq:得票率×改選議席数の中央値の閾値超え順位}
\end{equation}
$n=12$ の場合、$A = 0.7658\dots$ なので、例えば、\eqref{eq:得票率×改選議席数の中央値の閾値超え順位} に $T_{h}=1,C=6,n=12,A=0.7658$ を代入すると次のようになり、
\begin{equation}
k \le \frac{12 + 1/3}{10} ln \left( \frac{6}{0.7658} -1 \right) + \frac{1}{3}=2.70\dots \notag
\end{equation}
整数部分 $\lfloor p_{i}C \rfloor$ で議席を獲得できるのは得票率の順位が2位よりも高い政党で、3位以下の小政党は小数部分 $\{p_{i}C\}$ の順位で議席を獲得するしかない。$C=10,23,28$ に変えると、整数部分 $\lfloor p_{i}C \rfloor$ で議席を獲得できるのは、それぞれ3位、4位、4位までである。
ただし、これは $p_{i}C$ の中央値 $\operatorname{Med}(p_{i}C)$ を使った見積もりであって、1位政党の得票率が低い場合など、さらに下位の政党が整数部分 $\lfloor p_{i}C \rfloor$ で議席を獲得できる可能性もある。例えば、12位政党の得票率の理論的な最大値は $\operatorname{Max}(p_{12})=\frac{1}{12}=0.083\dots$ なので、$C=28$ の場合の $p_{i}C$ の理論的な最大値は $\operatorname{Max}(p_{12}C)=\frac{28}{12}=2.33\dots$ で整数部分 $\lfloor p_{i}C \rfloor$ で2議席を獲得できる可能性はある。
$T_{h}$ に自然数 $1,2,3,\dots$ を代入すれば、それぞれの議席を整数部分 $\lfloor p_{i}C \rfloor$ で獲得できる順位も見積もれるが、今は小数部分 $\{p_{i}C\}$ の順位で配分される議席数の総数 $m$ の値がどのくらいになるか見積もることが目的なので、\eqref{eq:得票率×改選議席数の中央値} に $n=12,A=0.7658$ を代入して、改選議席数 $C$ を変えて、各順位の政党が整数部分 $\lfloor p_{i}C \rfloor$ でどれだけの議席を獲得できるか一覧にして、その総数を計算する。その値を改選議席数 $C$ から引けば、\eqref{eq:小数の順位で配分される総議席数} のように $m$ が見積れる。
| 改選議席数 C | 1位 | 2位 | 3位 | 4位 |
|---|---|---|---|---|
| 6 | 2.884 | 1.611 | 0.809 | 0.381 |
| 10 | 4.806 | 2.685 | 1.348 | 0.635 |
| 23 | 11.054 | 6.176 | 3.100 | 1.462 |
| 28 | 13.457 | 7.519 | 3.773 | 1.779 |
| 改選議席数 C | 1位 | 2位 | 3位 | 4位 | 残数 m | シミュレーション 平均残数 |
|---|---|---|---|---|---|---|
| 6 | 2 | 1 | 0 | 0 | 3 | 2.4… |
| 10 | 4 | 2 | 1 | 0 | 3 | 2.7… |
| 23 | 11 | 6 | 3 | 1 | 2 | 3.2… |
| 28 | 13 | 7 | 3 | 1 | 4 | 3.3… |
シミュレーションで得られた残数の平均との差があるが、小数部分 $\{p_{i}C\}$ の順位で配分される議席数の総数 $m$ は3議席前後になることが多そうである。
次に小数部分の分布について考察する。
立候補政党数 $n$ が $12$ の場合、上位5党の得票率の分布は次のグラフのように近似できる。
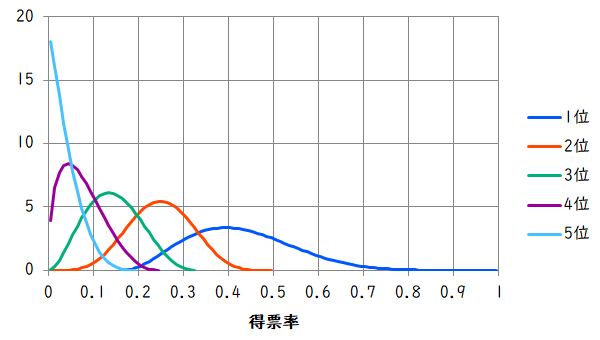
このグラフは次の数式をグラフにしたものである。
\begin{equation}
f(x)=\frac{\Gamma(\alpha+\beta)}{\Gamma(\alpha)\Gamma(\beta)}\frac{(x-a)^{\alpha-1}(b-x)^{\beta-1}}{(b-a)^{\alpha+\beta-1}} \label{eq:得票率の分布の近似式}
\end{equation}
\eqref{eq:得票率の分布の近似式} の各パラメーターは次の表のとおりである。
| 順位 | $\alpha$ | $\beta$ | a(下限) | b(上限) |
|---|---|---|---|---|
| 1 | 3.45 | 7.35 | 0.16 | 1 |
| 2 | 6.05 | 6.05 | 0 | $\frac{1}{2}=0.50$ |
| 3 | 2.95 | 3.85 | 0 | $\frac{1}{3}=0.33\dots$ |
| 4 | 1.55 | 3.55 | 0 | $\frac{1}{4}=0.25$ |
| 5 | 1.05 | 4.25 | 0 | $\frac{1}{5}=0.20$ |


横軸の得票率 $p_{i}$ を改選議席数 $C$ との積 $p_{i}C$ に変数変換してグラフにすると次のようになる。
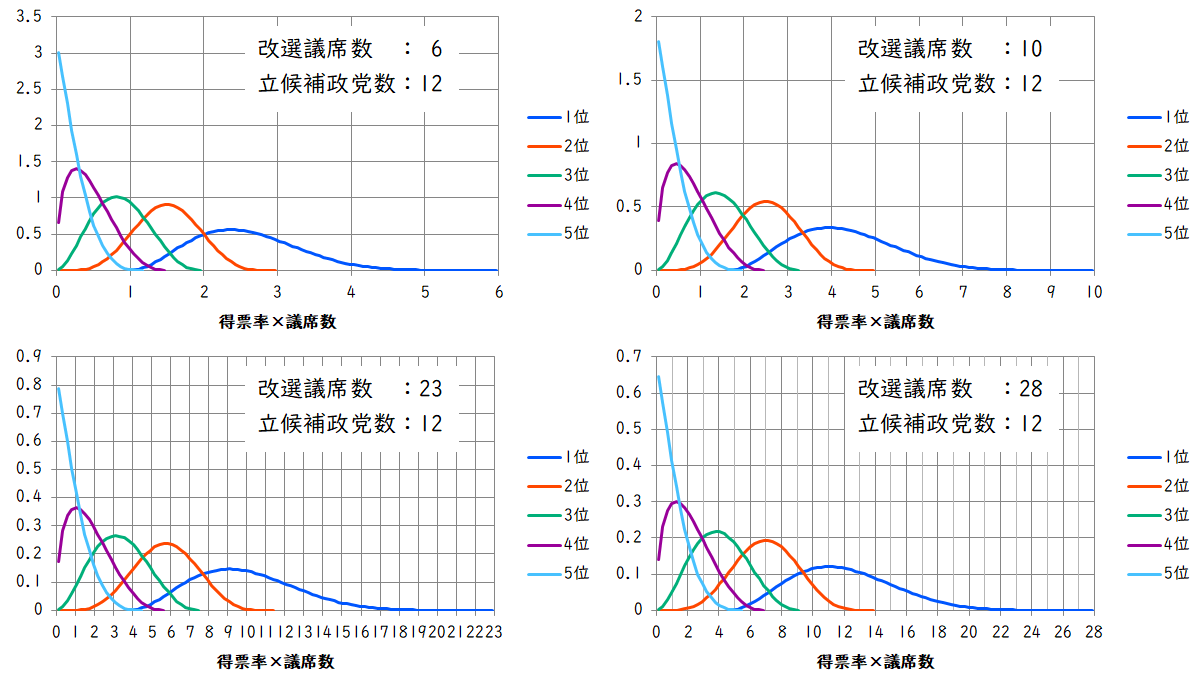
小数部分 $\{p_{i}C\}$ は $p_{i}C$ が整数 $j$ の時に $0$ になり、次の整数 $j+1$ まで上昇することを繰り返すから、小数部分 $\{p_{i}C\}$ の分布は得票率 $p_{i}$(=$\frac{\lfloor p_{i}C \rfloor + \{p_{i}C\}}{C}$)の分布を近似する式 \eqref{eq:得票率の分布の近似式} を使って次の式で表せる。
\begin{equation}
g(\{p_{i}C\})=\frac{1}{C}\sum_{j=0}^{C-1}f\left(\frac{j+\{p_{i}C\}}{C}\right) \label{eq:小数部分の分布の近似式}
\end{equation}
$g(\{p_{i}C\})$ をグラフにすると次のようになる。
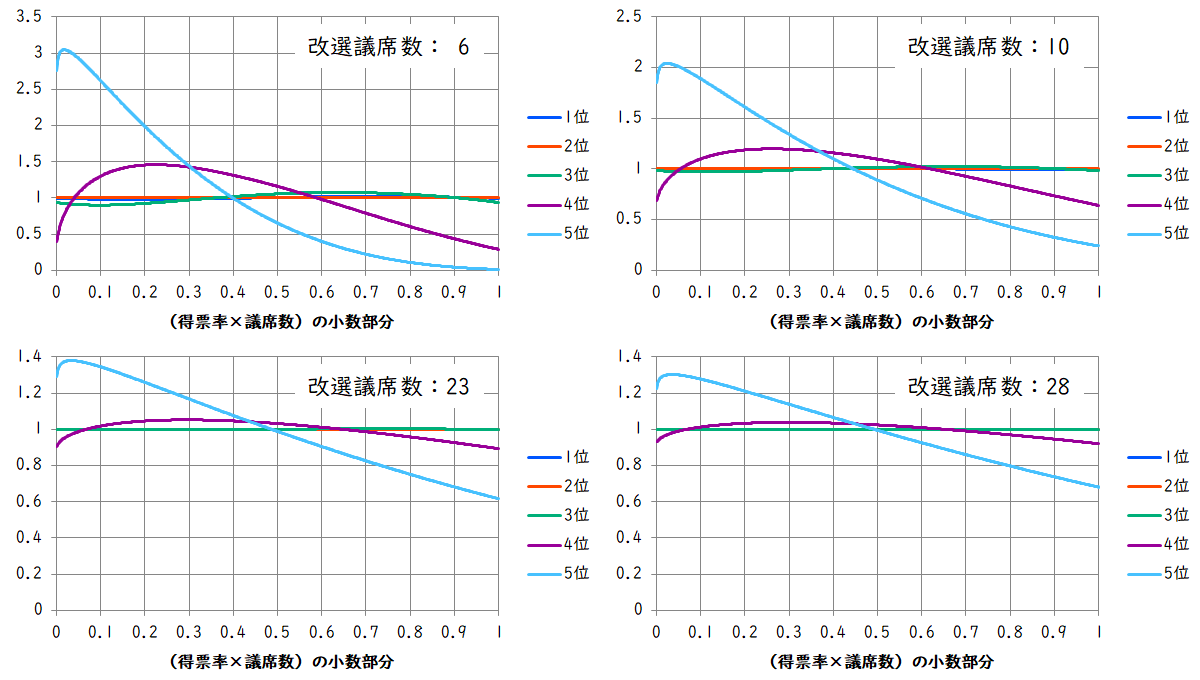
1位~3位の政党はほぼ一様分布になっているが、改選議席数 $C$ が $6$ の時は2位政党が最も一様分布に近く、1位政党、3位政党では若干ずれている。しかし、改選議席数 $C$ が $28$ に増えると、1位~3位の政党はグラフで違いが分からないほど重なり、一様分布とみなして良い状態になっている。一様分布であれば、小数部分 $\{p_{i}C\}$ の平均値(期待値)は $0.5$ になる。
\begin{equation}
\operatorname{E}[\{p_{i}C\}] \approx 0.5 \ (C=28, i = 1,2,3) \label{eq:大政党の小数部分の期待値}
\end{equation}
4位や5位の政党は小数部分($\{p_{i}C\}$)が $0.5$ よりも小さくなりやすいようで、5位政党の分布はほぼ単調減少である。
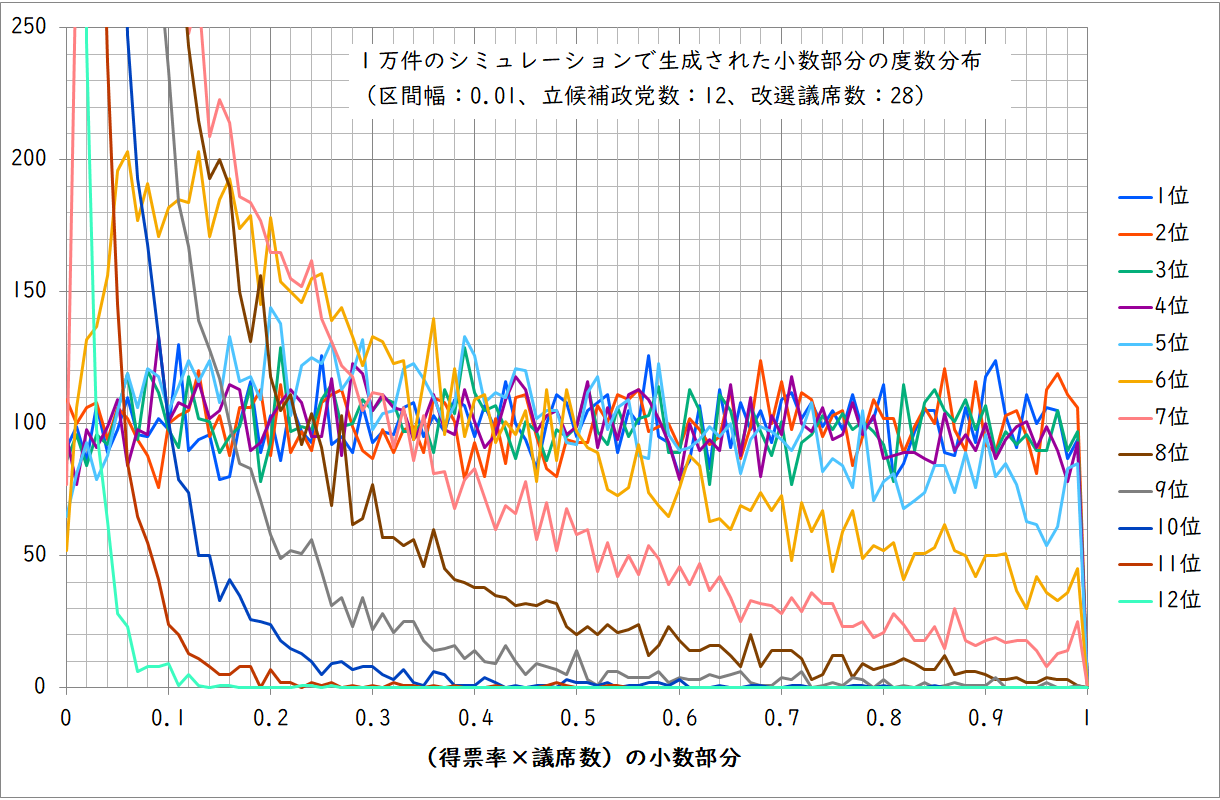
ただし、この結果は得票率をベータ分布で近似した結果 \eqref{eq:得票率の分布の近似式} を用いた式 \eqref{eq:小数部分の分布の近似式} をグラフにしたものであり、実際のシミュレーション結果は、立候補政党数 $n=12$、改選議席数 $C=28$ の場合の分布は次のようになっていて、$\{p_{i}C\}=1.0$ 付近の傾向や5位政党の傾向が若干異なるようにも見える。上記のグラフでは省略したが6位と7位の政党の $\{p_{i}C\} \lt 0.15$ の部分もベータ分布で近似することはできなかった。
以上を踏まえて、小数部分の値と議席獲得できる確率の関係について考察する。ただし、ここからは上位政党が一様分布に近い改選議席数 $C=28$ の場合に絞って考察する。立候補政党数は上記の例と同様に $n=12$ とする。
上記の通り、1位~3位までの政党の小数部分の期待値 $\operatorname{E}[\{p_{i}C\}]$ は約 $0.5$ であるが、小数部分 $\{p_{i}C\}$ の順位で配分される議席数の総数 $m$ の値が $2$ の場合、1位~4位までの全ての政党の小数部分 $\{p_{i}C\}$ の値が $0.5$ 以上になることはない。なぜならば、5位以下の政党の小数部分も加えると、次のようになり、\eqref{eq:小数の順位で配分される総議席数} の式 $m=\sum_{i=1}^{n} \{p_{i}C\}$ と矛盾してしまうからである。
\begin{equation}
\sum_{i=1}^{n} \{p_{i}C\} \gt m \label{eq:小数の順位で配分される総議席数との矛盾}
\end{equation}
これは、上記の分布は各順位の政党の小数部分 $\{p_{i}C\}$ の分布がどのようになっていたかを示す「結果」の分布であって、それらの分布の中から各政党の小数部分がランダムに選ばれたとみなしてはいけないということである。
そこで、各政党の小数部分 $\{p_{i}C\}$ は 一つの 確率密度関数からランダムに $n$ 個選ばれたのではなく、$\sum_{i=1}^{n} \{p_{i}C\}=m$ を満たすように 順番に 選ばれたと仮定することにする。小数部分を選んだ順(確定した順)に $X_{1}, X_{2}, X_{3}, \dots $ とすると、知りたいのは $X=x$ の時に $X_{k} \gt x$ となる $X_{k}$ の数が $m-1$ 個以内になる確率である。それが、$X=x$ が $m$ 位以内に入る確率、すなわち小数部分 $X=x$ で追加議席を獲得できる確率である。
$X_{1}$ が選ばれた確率密度関数を $f_{X_{1}}(t)$ 、累積分布関数を $F_{X_{1}}(t)$、$X_{2}$ が選ばれた確率密度関数を $f_{X_{2}}(t)$ 、累積分布関数を $F_{X_{2}}(t)$、$X_{k}$ が選ばれた確率密度関数を $f_{X_{k}}(t)$ 、累積分布関数を $F_{X_{k}}(t)$ とすると、$X_{1}$ 以外の確率密度関数と累積分布関数は、それ以前の $X_{k}$ が選ばれた前提での条件付き確率分布なので、次の右辺のように記した方が良いと思われるが、以下では省略して左辺のように記す。
\begin{empheq}[left=\empheqlbrace]{equation}
\begin{aligned}
f_{X_{1}}(t)&=f_{X_{1}}(t)\\
f_{X_{2}}(t)&=f_{X_{2} \mid X_{1}}(t \mid x_{1})\\
f_{X_{k}}(t)&=f_{X_{k} \mid X_{1}, \dots ,X_{k-1}}(t \mid x_{1}, \dots ,x_{k-1})\\
\end{aligned}
\label{eq:確率密度関数の厳密表現}
\end{empheq}
\begin{empheq}[left=\empheqlbrace]{equation}
\begin{aligned}
F_{X_{1}}(t)&=F_{X_{1}}(t)\\
F_{X_{2}}(t)&=F_{X_{2} \mid X_{1}}(t \mid x_{1})\\
F_{X_{k}}(t)&=F_{X_{k} \mid X_{1}, \dots ,X_{k-1}}(t \mid x_{1}, \dots ,x_{k-1})\\
\end{aligned}
\label{eq:累積分布関数の厳密表現}
\end{empheq}
さて、累積分布関数 $F_{X_{1}}(t)$ の分布から $n-1$ 個($X_{(1,1)},\dots,X_{(1,j)},\dots,X_{(1,n-1)}$)選んで $X_{(1,j)} \gt x$ となる $X_{(1,j)}$ が一つでもあれば、その内の一つを $X_{1}$ とする。$0$ 個であれば、$X=x$ を1位に確定し、$X$ 以外の $n-1$ 個の $X_{k}=x_{k}$ は $0 \lt X_{k} \lt x$ と次の条件を満たす任意の小数とする。任意の小数とするのは、その値が $X=x$ の順位に影響しないからである。
\begin{equation}
\sum_{k=1}^{n-1} x_{k}=m-x \label{eq:1位以外の小数}
\end{equation}
$X=x$ が1位になる確率 $P(1位)$、2位以下になる確率 $P(2位以下)$ は次のようになる。
\begin{empheq}[left=\empheqlbrace]{alignat=2}
&P(1位)&&=F_{X_{1}}(x)^{n-1} \label{eq:1位になる確率}\\
&P(2位以下)&&=1-F_{X_{1}}(x)^{n-1} \label{eq:2位以下になる確率}\\
\end{empheq}
$X_{1}$ が確定した前提の条件付き累積分布関数 $F_{X_{2}}(t)$ の分布から $n-2$ 個($X_{(2,1)},\dots,X_{(2,j)},\dots,X_{(2,n-2)}$)選んで $X_{(2,j)} \gt x$ となる $X_{(2,j)}$ が一つでもあれば、その内の一つを $X_{2}$ とする。$0$ 個であれば、$X=x$ を2位に確定し、$X$ と $X_{1}$ 以外の $n-2$ 個の $X_{k}=x_{k}$ は $0 \lt X_{k} \lt x$ と次の条件を満たす任意の小数とする。
\begin{equation}
\sum_{k=2}^{n-1} x_{k}=m-x-\sum_{k=1}^{1} x_{k} \label{eq:2位以外の小数}
\end{equation}
$X=x$ が2位になる確率 $P(2位)$、3位以下になる確率 $P(3位以下)$ は次のようになる。
\begin{empheq}[left=\empheqlbrace]{alignat=2}
&P(2位)&&=P(2位以下) \times F_{X_{2}}(x)^{n-2} \label{eq:2位になる確率}\\
&P(3位以下)&&=P(2位以下) \times (1-F_{X_{2}}(x)^{n-2}) \label{eq:3位以下になる確率}\\
\end{empheq}
$X_{1}, X_{2}$ が確定した前提の条件付き累積分布関数 $F_{X_{3}}(t)$ の分布から $n-3$ 個($X_{(3,1)},\dots,X_{(3,j)},\dots,X_{(3,n-3)}$)選んで $X_{(3,j)} \gt x$ となる $X_{(3,j)}$ が一つでもあれば、その内の一つを $X_{3}$ とする。$0$ 個であれば、$X=x$ を3位に確定し、$X$ と $X_{1}, X_{2}$ 以外の $n-3$ 個の $X_{k}=x_{k}$ は $0 \lt X_{k} \lt x$ と次の条件を満たす任意の小数とする。
\begin{equation}
\sum_{k=3}^{n-1} x_{k}=m-x-\sum_{k=1}^{2} x_{k} \label{eq:3位以外の小数}
\end{equation}
$X=x$ が3位になる確率 $P(3位)$、4位以下になる確率 $P(4位以下)$ は次のようになる。
\begin{empheq}[left=\empheqlbrace]{alignat=2}
&P(3位)&&=P(3位以下) \times F_{X_{3}}(x)^{n-3} \label{eq:3位になる確率}\\
&P(4位以下)&&=P(3位以下) \times (1-F_{X_{3}}(x)^{n-3}) \label{eq:4位以下になる確率}\\
\end{empheq}
$X_{1}, X_{2},\dots,X_{m-1}$ が確定した前提の条件付き累積分布関数 $F_{X_{m}}(t)$ の分布から $n-m$ 個($X_{(m,1)},\dots,X_{(m,j)},\dots,X_{(m,n-m)}$)選んで $X_{(m,j)} \gt x$ となる $X_{(m,j)}$ が一つでもあれば、その内の一つを $X_{m}$ とする。$0$ 個であれば、$X=x$ を $m$ 位に確定し、$X$ と $X_{1}$~$X_{m-1}$ 以外の $n-m$ 個の $X_{k}=x_{k}$ は $0 \lt X_{k} \lt x$ と次の条件を満たす任意の小数とする。
\begin{equation}
\sum_{k=m}^{n-1} x_{k}=m-x-\sum_{k=1}^{m-1} x_{k} \label{eq:m位以外の小数}
\end{equation}
$X=x$ が $m$ 位になる確率 $P(m位)$、$m$ 位以内に入れないことが確定する確率 $P(落選確定)$ は次のようになる。
\begin{empheq}[left=\empheqlbrace]{alignat=2}
&P(m位)&&=P(m位以下) \times F_{X_{m}}(x)^{n-m} \label{eq:m位になる確率}\\
&P(落選確定)&&=P(m位以下) \times (1-F_{X_{m}}(x)^{n-m}) \label{eq:落選が確定する確率}\\
\end{empheq}
そして、$X=x$ が $m$ 位以内に入る確率は次のようになる。
\begin{equation}
P(m位以内)=P(1位)+P(2位)+ \dots +P(m位) \label{eq:Xがm位以内に入る確率}
\end{equation}
このように、$F_{X_{k}}(t)$ が分かれば、$X=x$ が $m$ 位以内に入る確率を求めることができる。そこで、以下のように $F_{X_{k}}(t)$(数式では、条件付き累積分布関数の $F_{X_{k}}(t)$ ではなく、条件付き確率密度関数の $f_{X_{k}}(t)$)を仮定する。
全ての政党の小数部分の和は $m$ なので、次の条件を満たすように条件付き確率密度関数を仮定しなければいけない。
\begin{equation}
\sum_{k=1}^{n} x_{k}=m \label{eq:Xの合計}
\end{equation}
$X=x$ 以外の $X_{1}, X_{2},\dots,X_{k-1}$ が確定した後の残りの $n-k$ 個($X_{(k,1)},\dots,X_{(k,j)},\dots,X_{(k,n-k)}$)は次の条件を満たさなければならない。
\begin{equation}
\sum_{j=1}^{n-k} x_{(k,j)}=m-x-\sum_{j=1}^{k-1} x_{j} \label{eq:mの残数}
\end{equation}
両辺を $n-k$ で割ると、残りの $n-k$ 個の平均が右辺になることが左辺から分かる。
\begin{equation}
\frac{1}{n-k}\sum_{j=1}^{n-k} x_{(k,j)}=\frac{1}{n-k}\left(m-x-\sum_{j=1}^{k-1} x_{j}\right) \label{eq:n-k党の平均}
\end{equation}
$k=1$ の場合、すなわち $X_{1}$ が決まってない状態では次のようになる。
\begin{equation}
\frac{1}{n-1}\sum_{j=1}^{n-1} x_{(1,j)}=\frac{m-x}{n-1} \label{eq:n-1党の平均}
\end{equation}
ここで、条件付き確率密度関数 $f_{X_{k}}(t)$ が区間$[0,1)$の次のベータ分布で近似できると仮定する。
\begin{equation}
f_{X_{k}}(t)=f(t;\alpha_{k},\beta_{k})=\frac{\Gamma(\alpha_{k}+\beta_{k})}{\Gamma(\alpha_{k})\Gamma(\beta_{k})}t^{\alpha_{k}-1}(1-t)^{\beta_{k}-1} \label{eq:条件付き確率密度関数のベータ分布近似}
\end{equation}
ベータ分布の平均値(期待値)は $\mu_{k}=\frac{\alpha_{k}}{\alpha_{k}+\beta_{k}}$ なので、$\alpha_{k}$ と $\beta_{k}$ は次のようになる。
\begin{equation}
\mu_{k}=\frac{\alpha_{k}}{\alpha_{k}+\beta_{k}}=\frac{1}{n-k}\left(m-x-\sum_{j=1}^{k-1} x_{j}\right) \label{eq:ベータ分布近似の平均}
\end{equation}
\begin{empheq}[left=\empheqlbrace]{equation}
\begin{aligned}
\alpha_{k}&=\left(m-x-\sum_{j=1}^{k-1}x_{j}\right)R_{k}\\
\beta_{k}&=\left(n-k-m+x+\sum_{j=1}^{k-1}x_{j}\right)R_{k}
\end{aligned}
\label{eq:ベータ分布近似のαとβ}
\end{empheq}
$k=1$ の場合、すなわち $X_{1}$ が決まってない状態では次のようになる。
\begin{equation}
f_{X_{1}}(t)=f(t;\alpha_{1},\beta_{1})=\frac{\Gamma(\alpha_{1}+\beta_{1})}{\Gamma(\alpha_{1})\Gamma(\beta_{1})}t^{\alpha_{1}-1}(1-t)^{\beta_{1}-1} \label{eq:k=1のベータ分布近似}
\end{equation}
\begin{empheq}[left=\empheqlbrace]{equation}
\begin{aligned}
\alpha_{1}&=(m-x)R_{1}\\
\beta_{1}&=(n-1-m+x)R_{1}
\end{aligned}
\label{eq:k=1のベータ分布近似のαとβ}
\end{empheq}
\eqref{eq:ベータ分布近似のαとβ} の $R_{k}$ は平均値 $\mu_{k}=\frac{\alpha_{k}}{\alpha_{k}+\beta_{k}}$ だけからは定まらず、分散 $\sigma_{k}^{2}$ に影響し、次のようになる。
\begin{equation}
\sigma_{k}^{2}=\frac{\alpha_{k} \beta_{k}}{(\alpha_{k}+\beta_{k})^{2}(\alpha_{k}+\beta_{k}+1)}=\frac{\mu_{k}(1-\mu_{k})}{(n-k)R_{k}+1} \label{eq:ベータ分布近似の分散}
\end{equation}
$R_{k}$ が大きいと分散は小さくなり、$R_{k}$ が小さいと分散は大きくなる。また、グラフで見ると分布の形が大きく変わることもあり、例えば、$k=1$ の場合の $X=0.5$ での確率密度関数 $f_{X_{1}}(t)$ と累積分布関数 $F_{X_{1}}(t)$ のグラフは $R_{1}$ を変えると次のようになる。
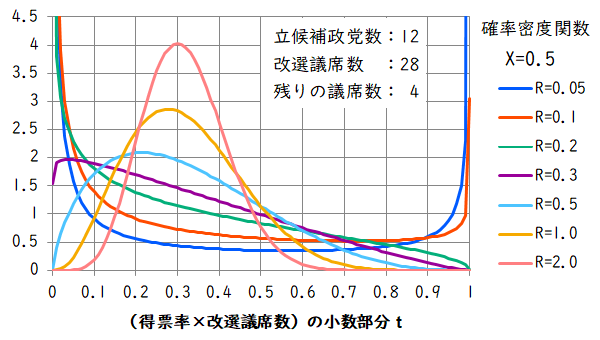
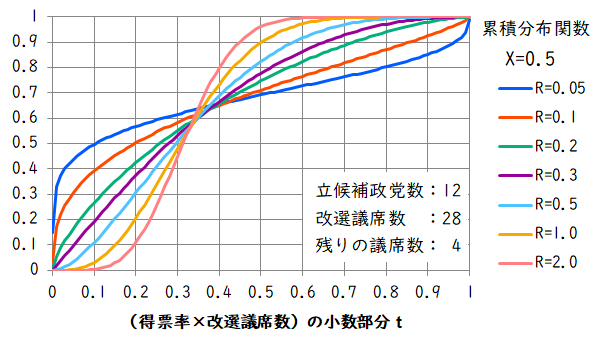
$X_{(1,j)} \lt 0.5$ の確率が $R_{1}=0.1$ では約70%、 $R_{1}=1.0$ では約90%である。
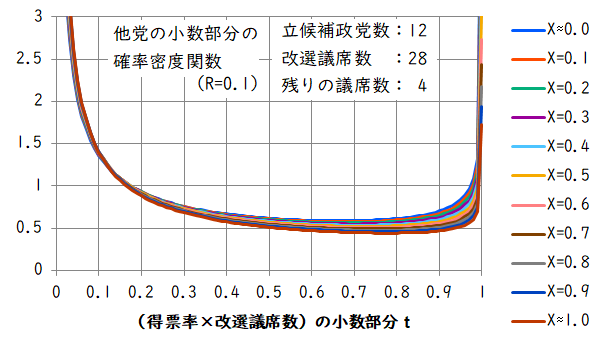
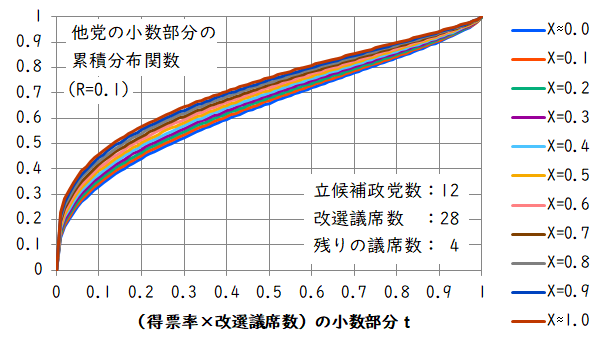
ただし、このグラフを見る時には注意が必要で、この分布は $X=0.5$ の時にしか成立しない。それは、\eqref{eq:ベータ分布近似のαとβ} のように、$\alpha_{k}$ と $\beta_{k}$ が $x$ の関数だからで、$X$ の値が変わると分布の平均値や分散も変わり、グラフの形も変わる。$R_{1}=0.1$ での確率密度関数 $f_{X_{1}}(t)$ と累積分布関数 $F_{X_{1}}(t)$ のグラフは $X$ を変えると次のようになる。
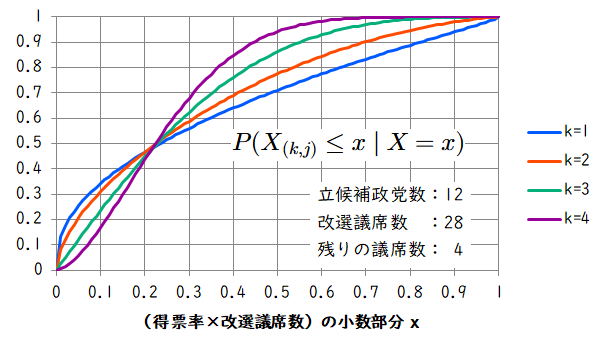
$X_{(k,j)}$ が $x$ 以下になる確率を求める式は次のようになる。
\begin{equation}
P(X_{(k,j)} \le x \mid X=x) = \int_{0}^{x} f(t; \alpha_{k}, \beta_{k}) \, dt = F(x; \alpha_{k}, \beta_{k}) \label{eq:X以下になる確率}
\end{equation}
\begin{empheq}[left=\empheqlbrace]{equation}
\begin{aligned}
\alpha_{k}&=\left(m-x-\sum_{j=1}^{k-1}x_{j}\right)R_{k}\\
\beta_{k}&=\left(n-k-m+x+\sum_{j=1}^{k-1}x_{j}\right)R_{k}
\end{aligned}
\label{eq:X以下になる確率のαとβ}
\end{empheq}
$F(x; \alpha_{k}, \beta_{k})$ はベータ分布の条件付き累積分布関数 $F(t; \alpha_{k}, \beta_{k})$ の $t=x$ での値である。
このように、$F_{X_{k}}(t)=F(t; \alpha_{k}, \beta_{k})$ を用意できたので、\eqref{eq:1位になる確率}~\eqref{eq:Xがm位以内に入る確率} のように $X=x$ が $m$ 位以内に入る確率 $P(m位以内)$ を求めることができる。
\begin{empheq}[left=\empheqlbrace]{equation}
\begin{alignedat}{2}
&P(1位)&&= F(x; \alpha_{1}, \beta_{1})^{n-1}\\
&P(2位以下)&&=1-F(x; \alpha_{1}, \beta_{1})^{n-1}\\
&\dots\\
&P(k位)&&= P(k位以下) \times F(x; \alpha_{k}, \beta_{k})^{n-k}\\
&P(k+1位以下)&&=P(k位以下) \times (1-F(x; \alpha_{k}, \beta_{k})^{n-k})\\
&\dots\\
&P(m位)&&= P(m位以下) \times F(x; \alpha_{m}, \beta_{m})^{n-m}\\
&P(m位以内)&&=P(1位)+ \dots +P(k位)+ \dots +P(m位)
\end{alignedat}
\label{eq:Xがm位以内になる確率を求める手順}
\end{empheq}
$n=12, m=4$ で $X=x$ が1位になる確率~4位になる確率($P(1位)$~$P(4位)$)をグラフにすると次のようになる。
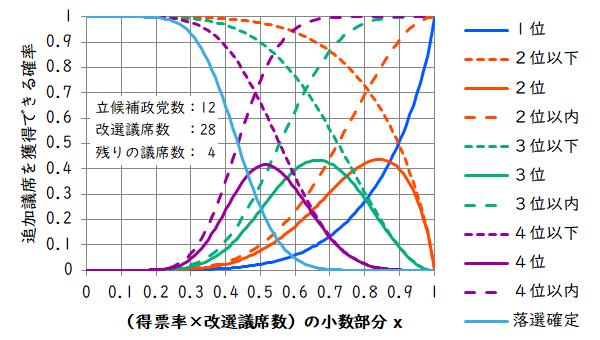
このグラフを作成するために、$\alpha_{k}$ と $\beta_{k}$ の式に含まれる $R_{k}$ と $x_{j}$ は次のように決めた。
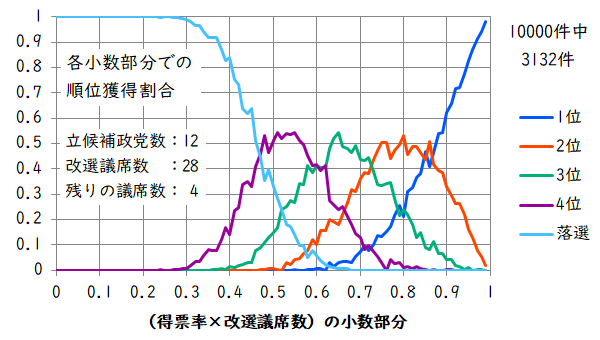
1万件のシミュレーション結果の内、小数部分の順位で配分する議席数が $4$ 議席になった $3132$ 件について、各小数部分の値で $1$ 位~$4$ 位を獲得できた割合をグラフにすると次のようになって、$2$ 位~ $4$ 位の山の高さがほぼ同じなので、そのようなグラフになるように $R_{1}$~$R_{4}$ を決めた。
| $R_{1}$ | $R_{2}$ | $R_{3}$ | $R_{4}$ |
|---|---|---|---|
| 0.10 | 0.15 | 0.28 | 0.50 |
また、\eqref{eq:1位になる確率}~\eqref{eq:Xがm位以内に入る確率} の手順に従い、$X_{1}, X_{2},\dots,X_{k-1}$ が確定した前提の条件付き累積分布関数 $F_{X_{k}}(t)$ の分布からランダムに $n-k$ 個($X_{(k,1)},\dots,X_{(k,j)},\dots,X_{(k,n-k)}$)選んで $X_{(k,j)} \gt x$ となる $X_{(k,j)}$ が一つでもあれば、$F_{X_{k}}(t)$ の区間[x,1)の平均(期待値)を $X_{k}=x_{k}$ とした。
\begin{equation}
x_{k}=E[X_{(k,j)} \mid x \le X_{(k,j)} \lt 1]=\frac{\alpha_{k}}{\alpha_{k}+\beta_{k}} \cdot \frac{1 - F(x; \alpha_{k}+1, \beta_{k})}{1 - F(x; \alpha_{k}, \beta_{k})} \label{eq:ベータ分布の区間平均}
\end{equation}
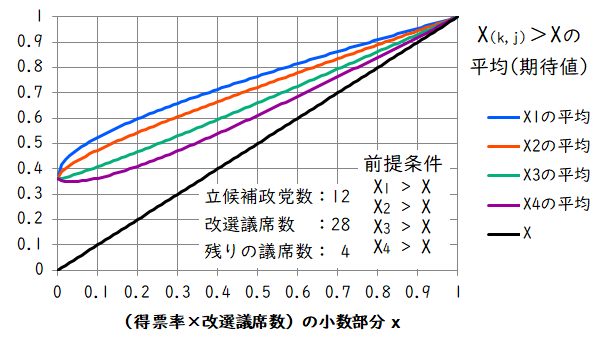
その上で、\eqref{eq:X以下になる確率} の $P(X_{(k,j)} \le x \mid X=x)$ をグラフにすると次のようになる。
そして、シミュレーション結果の「小数部分の順位で追加議席を獲得できる確率」のグラフ(ただし、小数部分の順位で配分される議席数は問わない)に上記の方法で求めた「$X=x$ が4位以内に入る確率」の曲線(グラフの「近似曲線」)を重ねると、次のようになる。
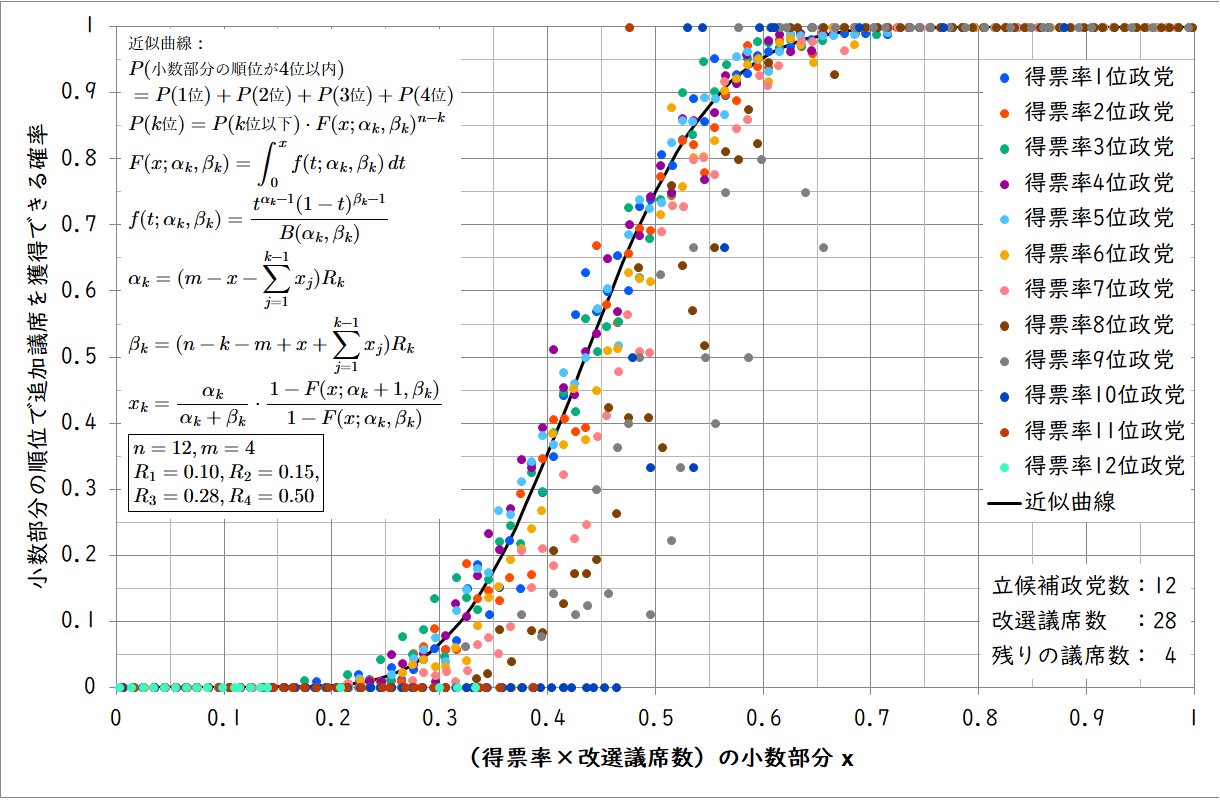
以上、最大剰余方式における小数部分の値と小数部分の順位で追加議席を獲得できる確率の関係について深掘りした。


コメント